Vercel에서 AWS Lambda로 생기부 OCR 실행 환경 분리하기
Hello, GSM은 광주소프트웨어마이스터고등학교 입학지원 서비스입니다.
기존에는 지원자가 입학원서를 작성할 때 생활기록부에 있는 정보를 직접 확인하고 비교하며 입력해야 했습니다. 생활기록부 PDF를 열어 필요한 정보를 찾고, 다시 지원서로 돌아와 하나씩 입력하는 과정이 반복되다 보니 작성에 시간이 오래 걸렸습니다.
특히 성적처럼 입력해야 하는 정보가 많은 경우에는 PDF와 지원서를 계속 번갈아 확인해야 했고, 잘못 입력한 값을 수정해야 하는 경우도 있었습니다.
이러한 과정을 개선하기 위해 이번에 정부24의 생활기록부 PDF를 업로드하면 필요한 정보를 자동으로 추출해 지원서에 입력할 수 있도록 OCR 기능을 도입했습니다.
1. OCR을 도입하게 된 이유
기존 지원서 작성 과정은 다음과 같았습니다.
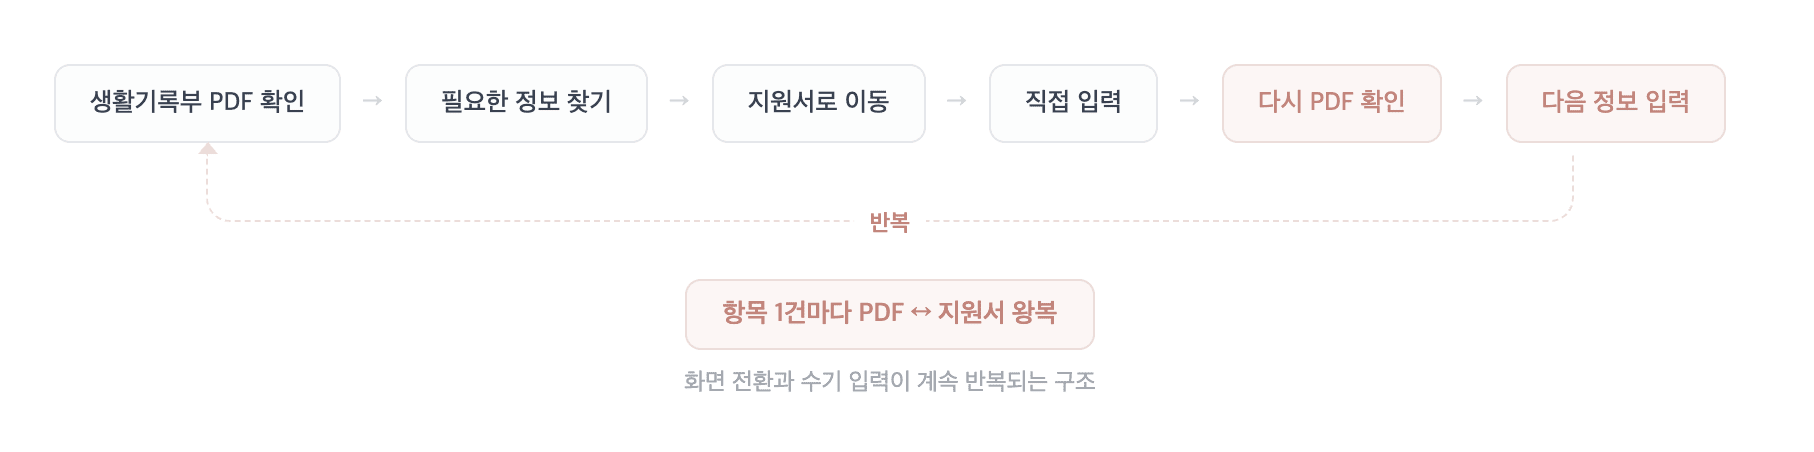
사용자가 생활기록부에서 필요한 정보를 직접 찾아 입력해야 했기 때문에 번거로운 과정이 반복되었습니다.
그래서 생활기록부를 업로드하면 서비스에서 필요한 정보를 자동으로 읽고, 지원서에서 사용할 수 있는 데이터 형태로 변환하는 것을 목표로 했습니다.
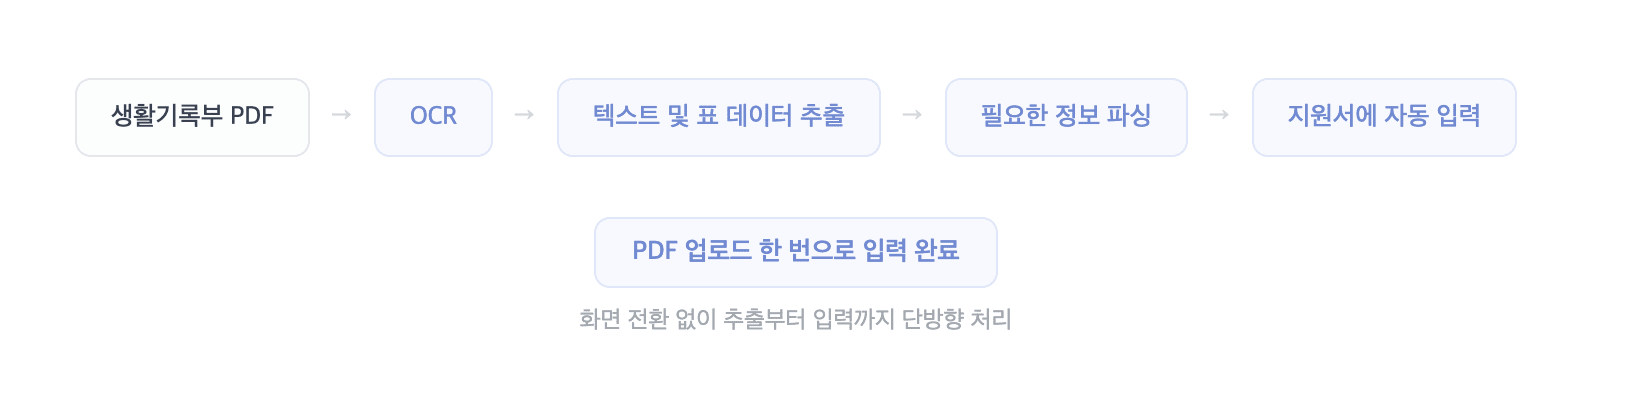
단순히 PDF의 텍스트를 가져오는 것이 아니라 생활기록부에 포함된 표와 여러 형식의 데이터를 처리해야 했기 때문에 OCR 기술을 사용하기로 결정했습니다.
2. OCR 라이브러리 선택
CR 기능을 구현하기 위해 여러 라이브러리를 찾아봤었는데요, 처음에는 브라우저에서도 사용할 수 있는 Tesseract.js로 구현했습니다.
우선 실제 정부24에서 발급한 생활기록부 PDF를 대상으로 테스트해봤습니다.
해당 PDF는 텍스트 레이어가 없는 이미지 기반 문서였기 때문에, PDF의 내용을 그대로 추출하는 것이 아니라 OCR을 통해 직접 내용을 인식해야 했습니다.
하지만 Tesseract.js로 테스트한 결과 인식률이 약 10% 정도에 그쳤고, 실제 서비스에 적용하기에는 정확도가 너무 낮다고 판단했습니다.
생활기록부는 일반적인 문서와 달리 여러 행과 열로 구성된 표가 많고, 한 페이지에 많은 정보가 포함되어 있습니다. 특히 스캔된 문서에서는 단순히 글자를 인식하는 것뿐만 아니라 표의 구조와 데이터를 함께 인식하는 것이 중요했습니다.
예를 들면 생활기록부에서는 교과목, 학기, 성적, 출결, 봉사활동 등을 정확하게 구분해야했기 때문입니다.
Tesseract.js로는 이러한 복잡한 문서 구조를 제대로 인식하기 어려웠고, 추출된 데이터 역시 실제 지원서에 바로 활용하기에는 수정해야 할 부분이 많았습니다.
그래서 한국어 문서와 표 형태의 데이터를 처리하는 데 적합한 다른 OCR 라이브러리를 찾아보았고, 그중 kordoc을 적용해 동일한 생활기록부를 다시 테스트했습니다.
그 결과 인식률이 약 80~90% 수준까지 향상되는 것을 확인할 수 있었습니다. 동일한 문서를 대상으로 테스트했을 때 인식률이 크게 향상되었고, 생활기록부의 표와 한국어 데이터를 처리하는 데에도 더 적합하다고 판단했습니다.
따라서 최종적으로 kordoc을 OCR 라이브러리로 선택했습니다.
3. Next.js에서의 직접 처리
처음부터 별도의 OCR 서버를 구성한 것은 아니었습니다.
Hello, GSM의 프론트엔드는 Next.js를 사용하고 있었기 때문에 우선 기존 서버 환경에서 OCR을 처리할 수 있도록 Next.js API Route에서 kordoc을 직접 실행하는 방식으로 구현했습니다.
전체적인 구조는 다음과 같았습니다
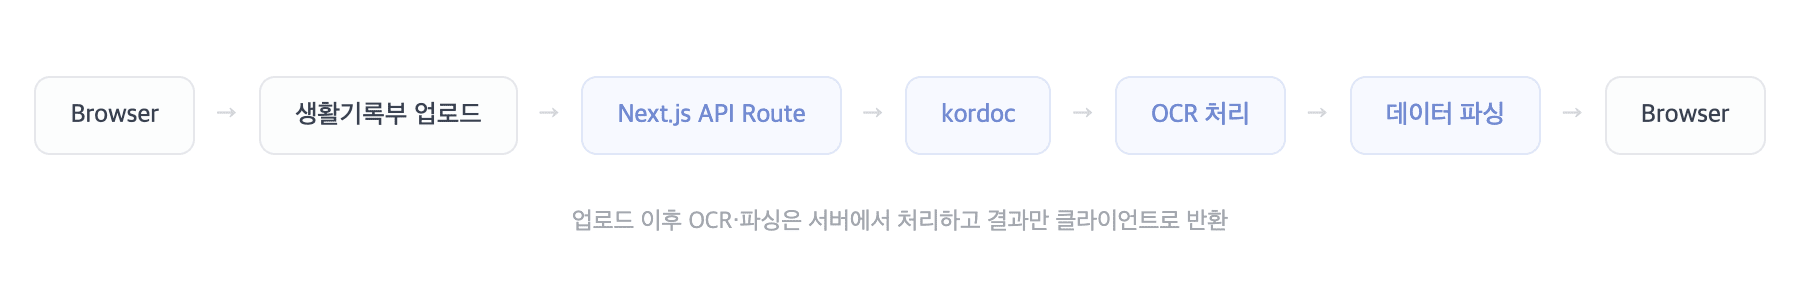
이 방식은 별도의 서버를 구성할 필요가 없고, 기존 Next.js 프로젝트 안에서 API를 추가하는 것만으로 구현할 수 있다는 장점이 있었습니다.
또한 인증이나 파일 처리 역시 기존 애플리케이션과 자연스럽게 연결할 수 있었기 때문에 처음에는 이 구조가 적절하다고 판단했습니다.
로컬 환경에서는 OCR이 정상적으로 동작했고, 실제 생활기록부 데이터를 넣어 필요한 정보가 추출되는 것까지 확인할 수 있었습니다.
하지만 문제는 배포 환경에서 발생했습니다.
4. Vercel 배포 과정에서 발생한 문제
Hello, GSM의 Next.js 애플리케이션은 올해 비용과 배포 관리 측면을 고려해 AWS에서 Vercel로 이전했고, 현재 Vercel을 통해 배포하고 있었습니다.
따라서 OCR API 역시 Vercel의 Serverless Function에서 실행하도록 구성했습니다. 그런데 배포를 진행하면서 Vercel의 Serverless Function 크기 제한에 걸리는 문제가 발생했습니다.
원인을 확인해보니 kordoc이 OCR을 수행하는 과정에서 여러 네이티브 의존성을 사용하고 있었습니다.
대표적으로 다음과 같은 라이브러리가 포함되어 있었습니다.
onnxruntime-node
sharp
@napi-rs/canvas
이러한 라이브러리는 일반적인 JavaScript 코드보다 많은 실행 파일과 바이너리를 필요로 합니다.
Next.js가 서버 함수를 빌드할 때 필요한 의존성을 자동으로 추적하면서 OCR에 필요한 파일까지 함께 포함되었고, 결과적으로 배포해야 하는 함수의 크기가 크게 증가했습니다.
결국 Vercel의 Serverless Function 크기 제한을 초과하게 되었습니다.
5. Vercel 안에서 해결해보기
처음부터 실행 환경을 변경하기보다는 현재 구조를 유지하면서 문제를 해결할 수 있는 방법부터 찾아봤습니다.
Next.js에는 서버에서 사용하는 파일을 배포 결과에 포함하기 위해 outputFileTracingIncludes를 사용할 수 있었습니다.
OCR에 필요한 파일만 명시적으로 포함하면 문제를 해결할 수 있을 것이라고 생각했습니다. 하지만 실제로 적용해보니 예상보다 많은 파일이 포함되었습니다.
특히 와일드카드 패턴을 사용했을 때 트레이싱 결과가 크게 증가했고, 배포 대상이 약 961MB까지 커지는 문제가 발생했습니다.
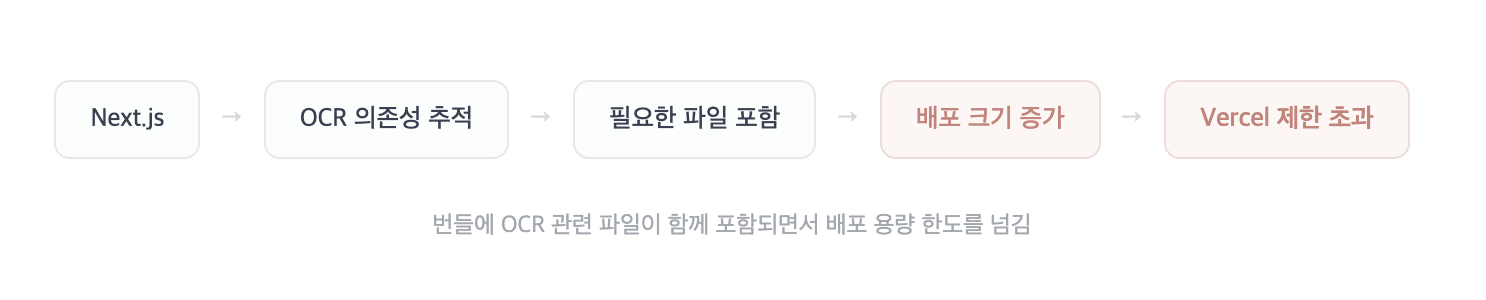
필요한 파일만 포함시키기 위해 여러 설정을 조정하고 심볼릭 링크 등을 활용하는 방법도 시도했습니다.
하지만 이 과정에서 단순히 파일 몇 개를 제외하는 것만으로는 해결하기 어려운 문제가 계속 발생했습니다.
설정을 계속 수정하면서 시간을 지체하는 것보다는 OCR을 실행하는 환경 자체를 분리하는 게 낫겠다는 생각이 들었습니다.
그래서 Vercel에서는 인증과 요청 처리만 담당하고, 실제 OCR은 별도의 서버에서 실행하는 방식으로 구조를 변경하기로 했습니다.
6. OCR 실행 환경을 분리
Vercel에서는 기존 서비스의 인증과 API 요청 처리를 담당하고, OCR처럼 무거운 작업은 AWS Lambda에서 처리하도록 역할을 나누었습니다.
최종적인 구조는 다음과 같습니다.
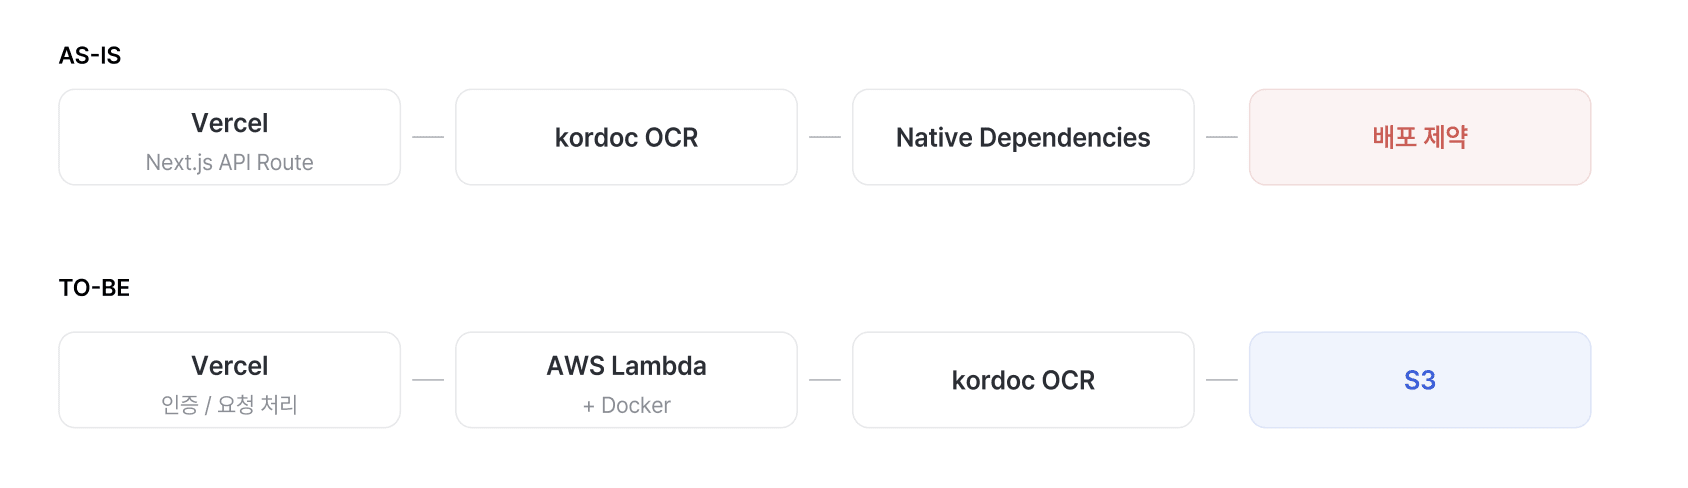
브라우저에서 생활기록부를 S3에 업로드하고, Vercel의 API에서는 해당 파일의 objectKey를 전달받습니다.
이후 Vercel이 Lambda를 호출하면 Lambda가 S3에서 파일을 가져와 OCR을 수행하고 결과를 반환합니다.
이렇게 하면 Vercel의 Serverless Function에는 OCR 라이브러리와 네이티브 의존성을 포함할 필요가 없어집니다.
#471
7. Lambda를 Docker 이미지로 구성
Lambda에서도 일반적인 ZIP 배포 방식 대신 컨테이너 이미지 기반으로 실행 환경을 구성했습니다.
OCR에 필요한 라이브러리와 네이티브 의존성을 Docker 이미지에 포함시키고, Lambda에서는 해당 이미지를 기반으로 OCR을 실행하도록 구성했습니다.
또한 Docker의 멀티스테이지 빌드를 사용해 빌드 과정에서만 필요한 파일과 실제 실행에 필요한 파일을 분리했습니다.
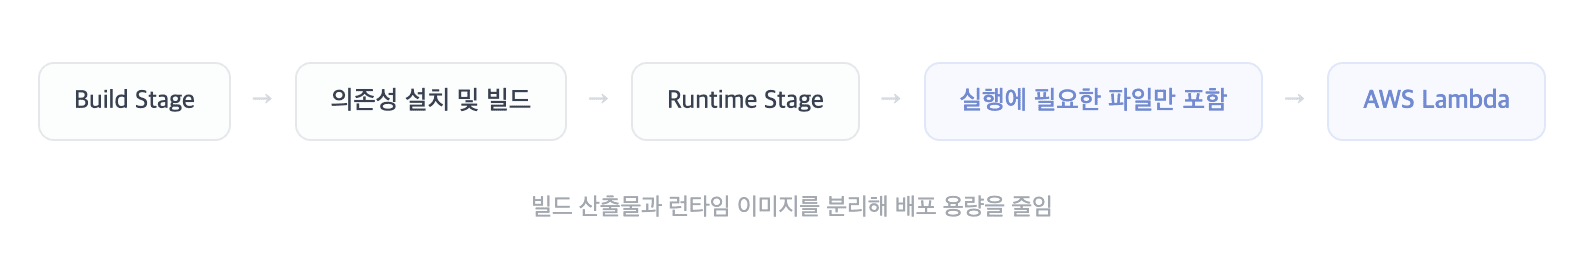
이를 통해 OCR 실행 환경을 Vercel과 분리하면서 Vercel의 파일 크기 제한 문제를 해결할 수 있었습니다.
8. Lambda에서 발생한 새로운 문제
OCR을 Lambda로 분리한 이후에도 새로운 문제가 발생했습니다.
OCR 모델을 Lambda 실행 시점에 다운로드하도록 구성했는데, 로컬 환경에서는 몇 초 안에 끝나던 OCR 작업이 실제 Lambda 환경에서는 약 5분 정도 걸리는 문제가 발생했습니다.
처음에는 OCR 자체가 오래 걸리는 것이라고 생각했지만, 각 단계를 나누어 확인해보면서 모델을 다운로드하고 초기화하는 과정이 상당한 시간을 차지하고 있다는 것을 확인했습니다.
기존 구조는 다음과 같았습니다.
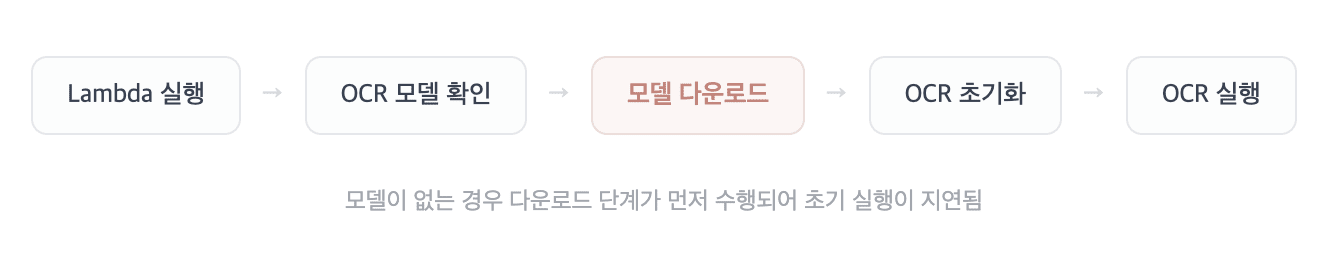
Lambda가 실행될 때마다 모델을 준비해야 했기 때문에 불필요한 초기화 시간이 발생하고 있었습니다.
9. OCR 모델을 Docker 이미지에 포함하기
이 문제를 해결하기 위해 OCR 모델을 Lambda 실행 시점에 다운로드하는 대신 Docker 이미지를 빌드하는 과정에서 미리 다운로드하도록 변경했습니다.
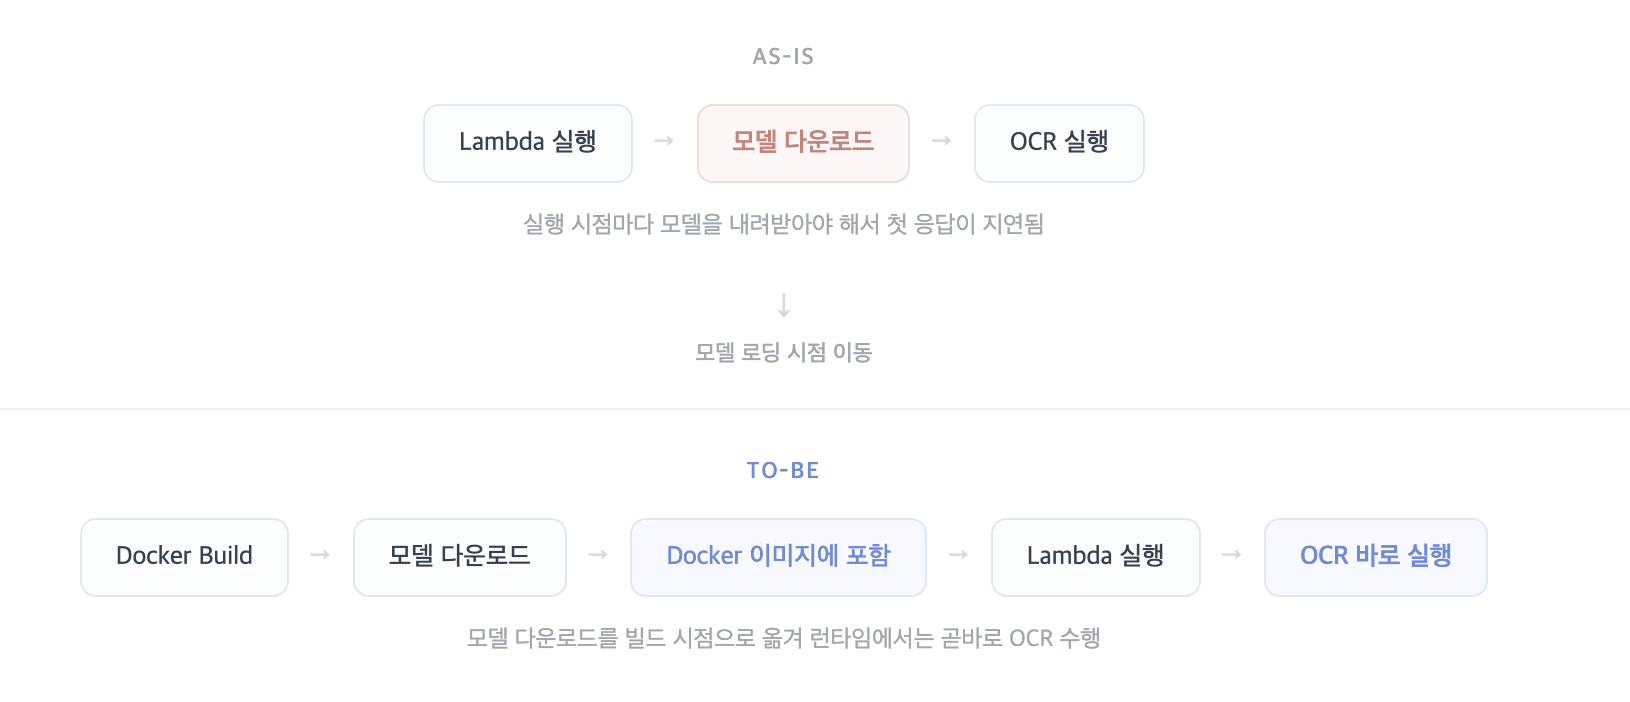
이렇게 변경하면서 Lambda가 실행될 때마다 모델을 다운로드할 필요가 없어졌습니다.
그 결과 OCR 처리 시간은 약 5분에서 2분 정도로 감소했습니다.
#485
10. 최종 결과
이번 작업을 통해 OCR 기능을 단순히 구현하는 것에서 끝내지 않고, 실제 배포 환경에서도 안정적으로 실행할 수 있도록 구조를 개선했습니다.
가장 큰 변화로는 Vercel에서 OCR에 필요한 의존성을 제거해서 그 결과 배포 과정에서 확인한 트레이싱 파일이 약 1,300개에서 168개로 감소했습니다.
Vercel에서는 OCR 관련 네이티브 의존성을 제거하고 인증과 API 요청 처리를 하도록 했고, OCR은 Lambda에서 독립적으로 실행하도록 분리했습니다.
또한 Lambda에서 OCR 모델을 미리 이미지에 포함하면서 모델 다운로드 과정도 제거했고, OCR 처리 시간 역시 약 5분에서 2분으로 줄일 수 있었습니다.
11. 마무리
약 한 달간 OCR 기능을 작업하면서 처음에는 생각보다 간단한 작업이라고 생각했습니다.
하지만 개발 과정에서 예상하지 못한 오류를 계속 마주했고, 해결 방법이 보이지 않아 좌절하기도 했습니다.
처음에는 제 역량이 부족해서 해결하지 못하는 건가라는 생각도 들었지만, 이미 시작한 작업인 만큼 끝까지 제대로 해보자는 생각으로 하나씩 원인을 찾아 해결했던 것 같아요
이번 경험을 통해 단순히 OCR 기능을 도입한 것뿐만 아니라, 개발자로서 어려운 문제를 마주했을 때 쉽게 포기하지 않고 끝까지 해결해보는 자세가 중요하다는 것을 배웠습니다. 앞으로도 새로운 기술이나 어려운 문제를 두려워하기보다는 직접 부딪히며 해결해나가는 개발자가 되고 싶습니다.
쓰다 보니 글이 길어졌는데 끝까지 읽어주셔서 감사합니다! 🙇🏻♀️